

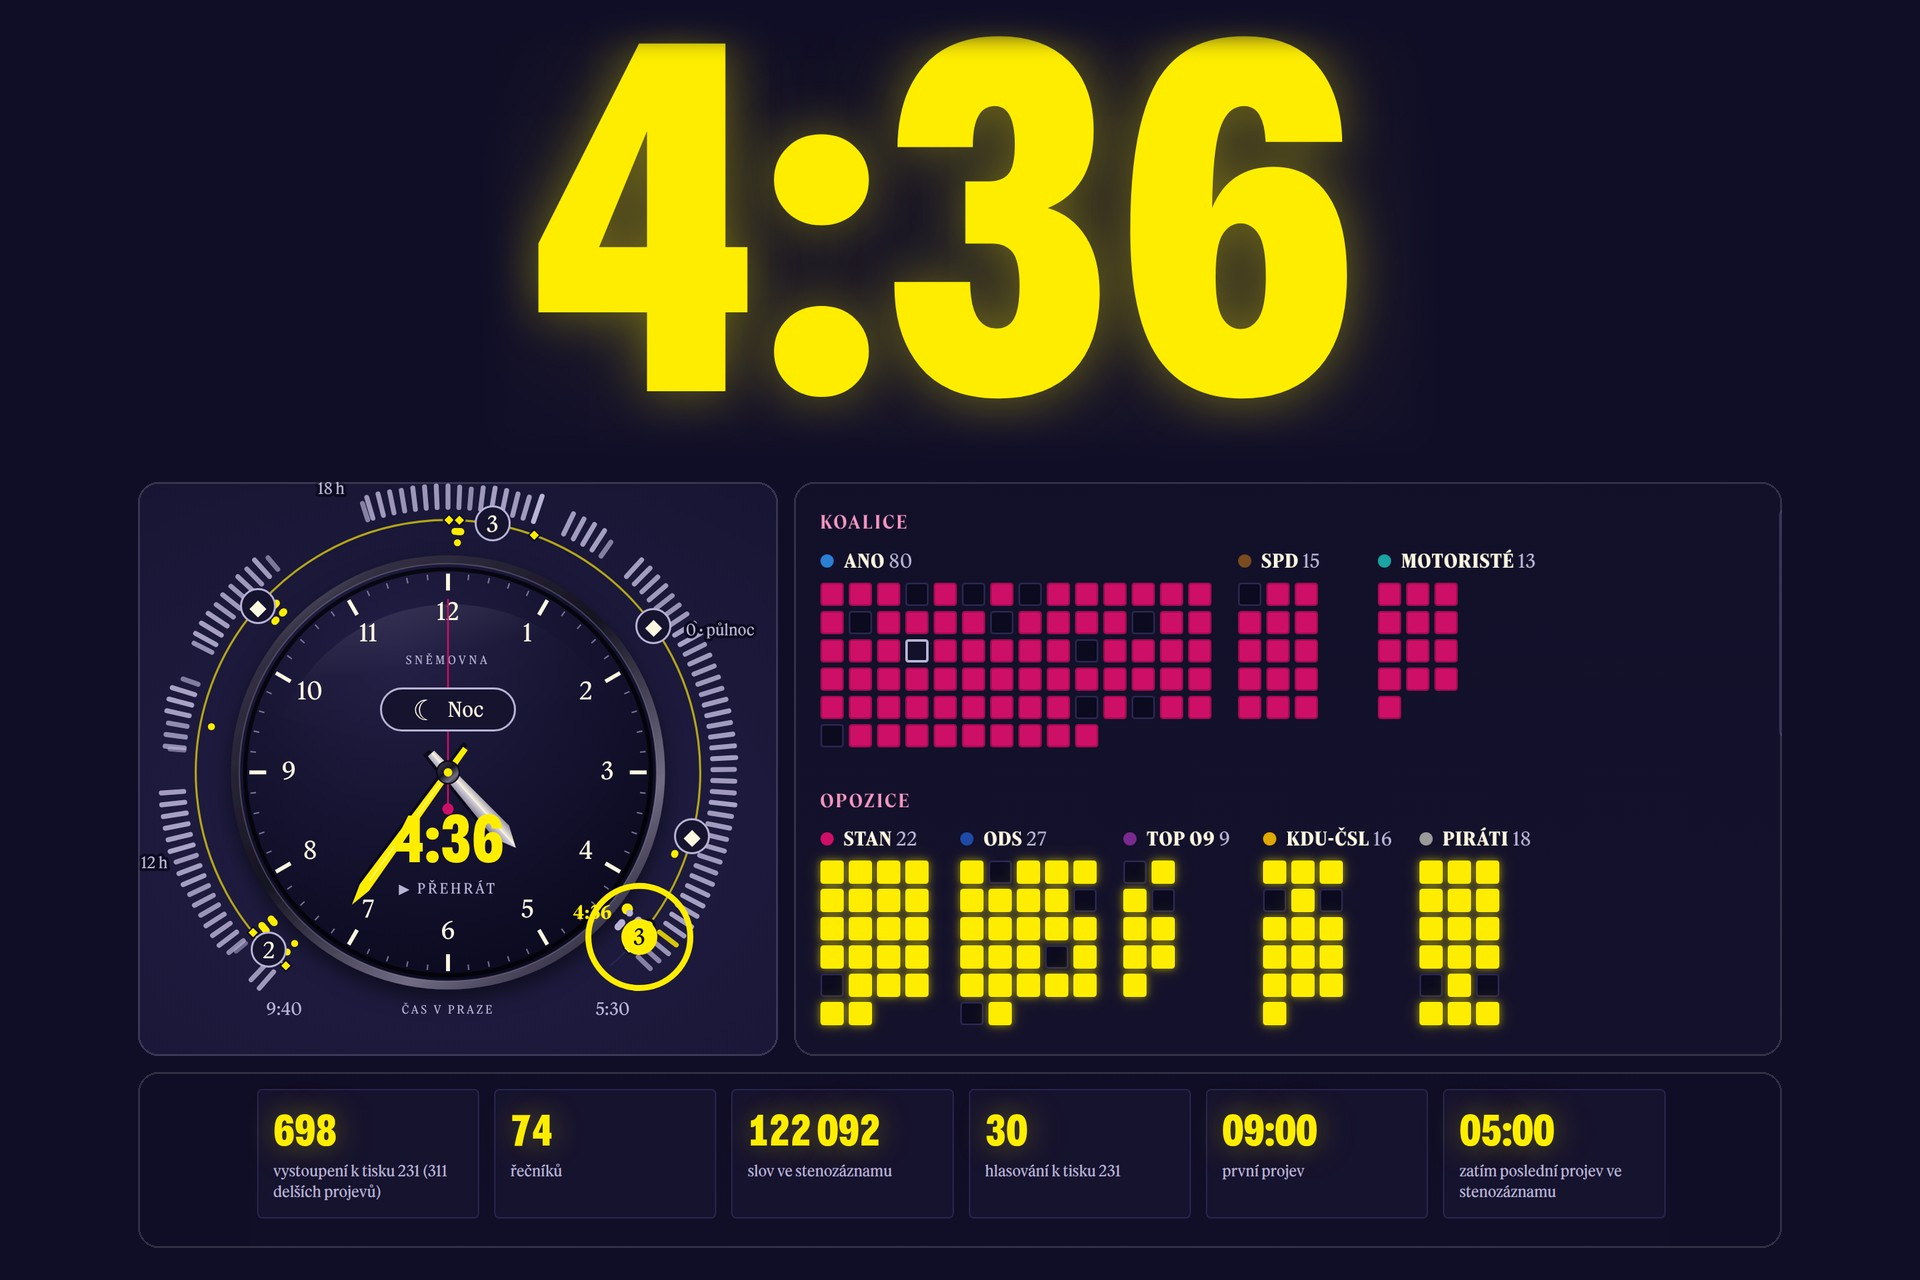
4:36 – ani ve světových dějinách neznáme mnoho případů, kdy by se přesný čas tak rychle stal pojmem v politice celé země. Vládní koalice během celého procesu předvedla několik ukázek naprostého diletantství. O tom ale v článku psát nechci. Jsem pevně přesvědčen, že emoce do politiky patří, ale její základ mají tvořit důkazy a znalosti. Právě tahle víra mě přiměla hned v sobotu začít stavět web, který by poskytl co nejvíce faktů.
Web se jmenuje 4:36, nachází se na adrese https://chranime.media a je oficiálním webem hnutí STAN. Sám o sobě přiznává, že je „angažovanou dokumentací zápasu o veřejnoprávní média“. Od 24. října ho stavím spolu s jazykovými modely. Nejsem nestranný pozorovatel. Jsem stínový ministr v Kabinetu budoucnosti hnutí STAN. Vít Rakušan představil web jako místo, které „staví fakta proti iracionálním útokům na veřejnoprávní média“. Fakta se dají zjišťovat a nezávisle ověřovat, a nejen v tom umělá inteligence dnes může velmi pomoci, pokud ji dokážete řídit.
Když lidem řeknu, že něco vzniklo s umělou inteligencí, většina si nejspíš představí vlastní pokusy: položit chatbotu otázku, dostat sebevědomou odpověď a doufat, že je pravdivá. Takhle na věcech, na kterých záleží, nepracuji. Výsledek sice může vzniknout velmi rychle – tenhle web vznikal necelé dva týdny. Jenže rychlost nepochází z jednoho chytrého zadání. Už měsíce ladím stovky takzvaných skillů – uložených pracovních postupů, které si model načte, když se pustí do daného typu práce. Určují, co má ověřit proti zdroji, kdy výsledek předat ke kontrole druhému modelu a jak zapsat chybu, aby se neopakovala. Po každém přehmatu je upravuji. A mám několik vlastních projektů, na kterých můžu stavět. Za většinou z nich jsou měsíce vytrvalé práce.
Vlastní archiv Sněmovny
Z těchto projektů se mi pro web 4:36 nejvíc hodí vlastní databáze stenozáznamů, kterou jsem začal stavět v dubnu, půl roku před říjnovou nocí ve Sněmovně. Sněmovna stenozáznamy zveřejňuje na psp.cz, jenže hledat v nich napříč lety a ve všech tvarech slova a pak doslovně citovat je práce pro trpělivého archiváře. Dnes databáze obsahuje přes 850 tisíc parlamentních projevů od ústavodárného rakouského říšského sněmu z roku 1848 po letošní listopad, od Sněmu království českého přes Federální shromáždění po Senát a Poslaneckou sněmovnu, k tomu tiskové konference vlády a přes 80 tisíc jmenovitých hlasování od roku 1993.
Hledá se v ní podle slov ve všech tvarech i podle významu, takže dotaz najde i projev, který o stejné věci mluví jinými slovy. Nejdůležitější funkce je ale nenápadná: ověření citátu. Doslovná věta se porovná s uloženým textem projevu a „skoro stejná“ neprojde. Kód z velké části napsaly podle mých zadání modely Sonnet, Opus a Fable od Anthropicu a Sol a Astra od OpenAI; pracoval jsem s nimi v prostředích Claude Code a Codex. Já jsem rozhodoval, co má databáze umět, a kontroloval, co vrací. Databáze má i svá omezení: běží na domácím serveru, není veřejně dostupná a Sněmovna ještě týdny redakčně upravuje původní hrubé stenozáznamy poslední schůze na psp.cz.
Noc projev po projevu
Z databáze skript vytáhl všech 698 záznamů projevů noci včetně procedurálních vystoupení: 74 řečníků, přes 122 tisíc slov. Stenozáznam neuvádí čas u každého projevu, jen občasné poznámky typu „(16.20 hodin)“, a skript proto dal každému projevu čas poslední poznámky před ním. U 274 delších projevů je shrnutí do 45 slov. Dnes je píše model GPT-6.1 Sol od OpenAI a každé proti celému projevu kontroluje Claude Opus od Anthropicu. Na webu je každé označené jako „strojové shrnutí“ a vede k plnému textu, který je rozhodující.
Úryvky do přehrávače noci vybírá stejná dvojice. Sol najde v celém projevu pasáž s hlavním sdělením řečníka, skript ji přijme, jen když je doslova ve stenozáznamu, a Opus pak posoudí, zda vytržená věta nezkresluje řečníkův postoj. Bez jeho kontroly se úryvek na web nedostane; v přehrávači je jich 240. Sněmovna zatím na psp.cz redakčně upravila 183 projevů noci. Skript pak úryvek přenese na nové znění, nebo ho vyřadí; přenesený úryvek, který se změnil, ztratí dosavadní kontrolu a na web se vrátí, až ho Opus posoudí znovu. Všech 105 výroků má odkaz na zdroj a ty sněmovní skript přijme, jen když doslova odpovídají dnešnímu znění stenozáznamu. Krátký kontext ke každému připravuje GPT-6 Astra od OpenAI podle pravidel neutrality a kontroluje ho redakce; bez něj se výrok na web nedostane.
Značka „✓ shoda se záznamem“ u citátu znamená jen to, že citát odpovídá stenozáznamu, ne že je jeho obsah pravdivý. A u každého z 62 hlasování stojí, o čem se hlasovalo a co v něm znamenalo „ano“; u procedurálních hlasování ve čtyři ráno to bez vysvětlení nepozná ani pozorný divák přenosu. Princip je pořád stejný: model navrhuje, primární záznam rozhoduje. Má to ovšem mez. Doslovný citát může být vytržený z kontextu a správný výpočet může stát na špatném předpokladu; samotná kontrola doslovnosti ani výpočtu to neodhalí.
Hry a kalkulačky
Stenozáznam málokdo otevře, a tak web nabízí i tři kvízy a přehrávač noci. V kvízu Kdo to řekl? čtenář hádá autory 25 doslovných úryvků z noční rozpravy. Aby žádná strana nepřevažovala, je poměr zapsaný přímo v datech: 13 úryvků koalice, 12 opozice, v žádné sadě víc než 3 : 2. Nejraději mám přehrávač Noc do 4:36: hodiny v něm běží od 9:40 dopoledne do půl šesté ráno a vedle nich se odvíjí osa toho, co se kdy dělo a kdo zrovna mluvil. Úlohy napsaly modely, grafiku ve dvou kolech navrhla Astra a o tom, co se zveřejní, jsem rozhodoval já. Jestli kvízy někomu pomohly noci porozumět, nevím.
Kalkulačky ukazují, kolik dnes platí domácnost a co by pro ČT a ČRo v čase znamenal příspěvek ze státního rozpočtu. Výpočty hlídají automatické testy a jeden z nich přepočítává tabulku z vládní analýzy dopadů: musí vyjít stejná čísla jako vládě. Při aktualizacích webu používám Astru jako oponenta; o zveřejnění rozhoduji já.
Politika založená na důkazech
Představa politiky založené na důkazech je jednoduchá: rozhodovat podle toho, co víme, ne podle toho, co se hodí. Proč to v praxi drhne, připomíná politolog Paul Cairney v knize The Politics of Evidence-Based Policy Making i ve volně dostupném textu na svém blogu. Politici nemohou zvážit všechny důkazy a o politice rozhodují i hodnoty a vyjednávání. Podle OECD navíc dlouhodobě vázne spojení mezi těmi, kdo důkazy vytvářejí, a těmi, kdo je potřebují.
Náš web pomáhá se zjištěním, co kdo opravdu řekl a jak hlasoval. Zda to, co řekl, odpovídá skutečnosti, už vyžaduje další prameny a věcnou kontrolu. A které opatření je lepší, je otázka výzkumu, ale i hodnot: zda platit veřejnoprávní média z poplatků, nebo ze státního rozpočtu, žádný důkaz sám nerozhodne. Ukáže jen, o čem se rozhoduje a co která volba stojí.
Ale „jen“ urychlení přístupu k faktům je velmi důležité. Kdo jak hlasoval, je na psp.cz veřejné. Vše najít a propojit s tím, co kdo v noci řekl, a srozumitelně vysvětlit, co které „ano“ znamenalo, je lidská práce na dny; umělá inteligence to při rozumném vedení zvládne za hodiny.
Důkazy pro jednu stranu?
Nabízí se námitka: není tohle celé jen chytřejší propaganda? Web provozuje politické hnutí a kritici politiky založené na důkazech varují před jejím opakem, důkazy hledanými k předem hotovému závěru. Výběr toho, co web dokumentuje, které výroky a citáty ukazuje a jak noc rámuje, je opravdu redakční a stranický. Web to o sobě říká a já to nezastírám.
Záznamy z té noci ale vybrané nejsou. Na webu jsou všechny projevy a všechna hlasování, každý klub se zobrazuje stejně a každý údaj má u sebe zdroj. Kdo nesouhlasí, nemusí věřit mně ani modelu, může si to ověřit. Podobný archiv si navíc může postavit i kdokoli jiný: opozice, koalice, novinář. Pokud si opatří data, technické zázemí a čas na kontrolu. Levnější ověřování není výsadou jedné strany; zdražuje tvrzení, která se nedají doložit.
Umělá inteligence nevyrobí pravdu a nenahradí politický úsudek. Může ale udělat z ověřitelnosti běžný standard místo luxusu, který si dovolí jen velká redakce s datovým týmem.
Stejně jako většina mých textů vznikl i tento v dialogu s několika jazykovými modely. Pomáhají mi s formulacemi, protiargumenty a oponováním mým závěrům. Více v úvodním textu blogu.